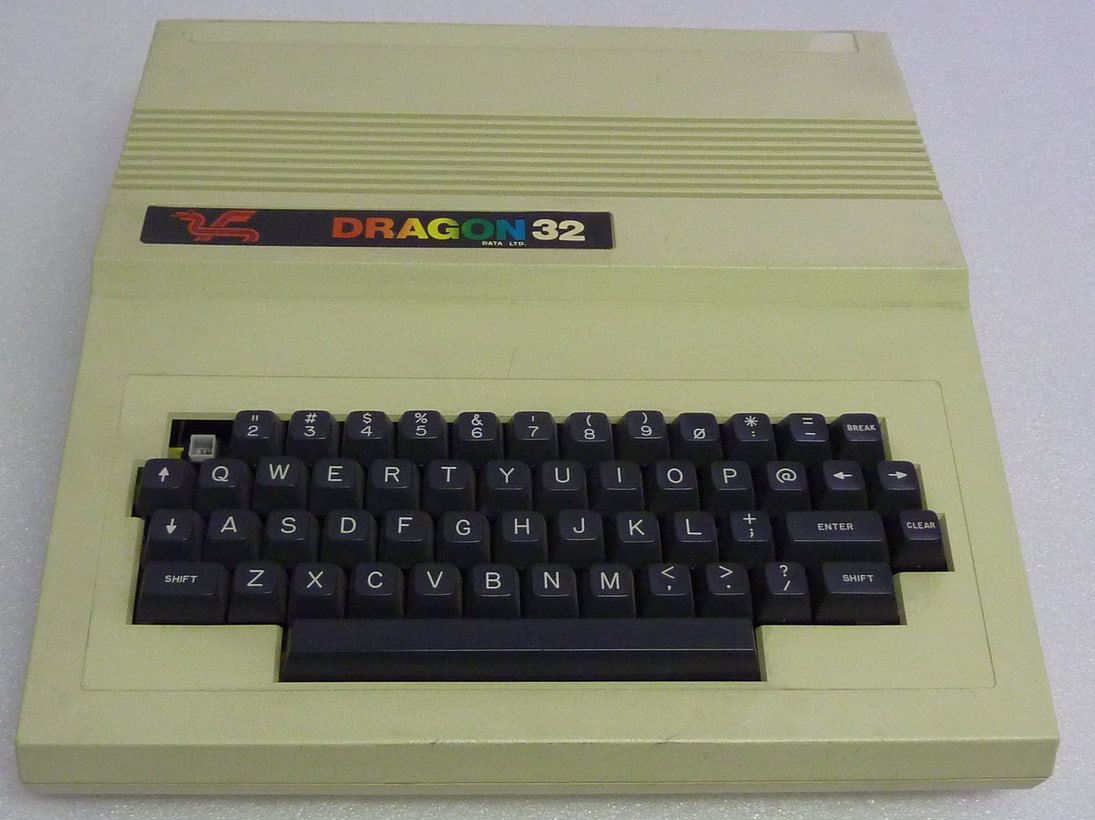
Mit 13 Jahren habe ich noch Programme von Kassette geladen und war froh, wenn sie in die 32 KB hineinpassten. Im Vergleich dazu ist die Verfügbarkeit von Daten heute enorm: Auf Hugging Face stehen mittlerweile über eine Million Datensätze für verschiedenste Anwendungen zur Verfügung. Das Salz in der Suppe war noch nie so billig.
Datenqualität und Benchmarks
Obwohl die Menge an Daten gigantisch ist, stellt sich die Frage, ob es einen Benchmark für diese Daten gibt. Ich hatte das Glück, passende Daten finden und diese so weit erweitern zu können, dass ich damit meine erste LoRA trainieren konnte.
Dabei ist klar geworden: KI-Modelle zu trainieren kostet nicht nur Zeit und GPU-Leistung, sondern vor allem gute Daten – und zwar solche, die das Basismodell noch nicht kennt.
Das Projekt: Von der Sprachnachricht zum Gutachten
Ich habe ein Projekt entwickelt, das aus Audio-Dateien (einem 1:1-Gespräch) ein transkribiertes und am Ende ein anonymisiertes Gutachten als PDF erstellt. Wer möchte, kann das Projekt zu Schulungszwecken gerne ausprobieren.
Die Pipeline des Projekts sieht wie folgt aus: Eine Telegram-Sprachnachricht wird über WhisperX und Pyannote in Text umgewandelt (inklusive Speaker Diarization). Dieser transkribierte Text wird dann mittels eines Qwen2.5-7B Modells, das mit einer LoRA (4-bit QLoRA) feinjustiert wurde, in ein strukturiertes PTV-3 JSON-Format gebracht. Das Endergebnis ist ein DIN A4 PDF-Bericht, der via Telegram ausgeliefert wird.
Das Projekt wurde in drei Etappen realisiert:
- Etappe 1 (Telegram Bot + Transkription): Ein Bot empfängt Sprachnachrichten, transkribiert sie mit WhisperX (large-v3) und führt eine Sprechererkennung mit Pyannote durch, um ein formatiertes Transkript zurückzugeben.
- Etappe 2 (Synthetische Datengenerierung): Es wurden 311 synthetische deutsche Samples (280 zum Training, 31 zur Validierung) für das LoRA-Fine-Tuning erstellt. Dies geschah über eine zweistufige Synthese mit einem lokalen Qwen2.5-27B: Zuerst wurden klinische Profile (Diagnose, Demografie, Therapieziele) generiert, woraus dann simulierte Therapie-Transkripte und die dazugehörigen strukturierten PTV-3 JSON-Berichte entstanden.
- Etappe 3 (QLoRA Fine-Tuning + Evaluation): Ein 155 MB großer LoRA-Adapter wurde mit Unsloth (4-bit QLoRA) auf Basis eines Qwen2.5-7B-Instruct Modells trainiert. Die Evaluation erfolgte mittels ROUGE-L, strukturellen Checks, Cosine Similarity und Pydantic.
Die Trainingsdaten wurden auf einer RTX 5090 (32 GB VRAM) über 90 Minuten mit 3 Epochen trainiert, wobei eine finale Loss von 0,37 und eine Cosine Similarity von 0,92 erreicht wurde.
Die Entwicklung der Open Models
Die Welt der KI bewegt sich extrem schnell. Laut einem Bericht von Hugging Face aus dem Sommer 2026 wachsen die öffentlichen Modell-Repositories, Datensätze und Spaces täglich massiv an. Dabei zeigt sich jedoch eine extrem ungleichmäßige Verteilung: Während die Anzahl der Datensätze auf über eine Million gestiegen ist, entfallen 99,2 % aller Downloads auf nur 1,5 % der Repositories.
Ein auffälliger Trend im Jahr 2026 ist die Geschwindigkeit der Entwicklung. Während früher Labore oft mit kleinen Modellen starteten, um sich hochzuarbeiten, überspringen chinesische Labore diesen Prozess oft komplett. Die leistungsstärksten Open-Source-Modelle aus China übertreffen in vielen Monaten die US-Modelle deutlich. Während US-Modelle oft unter 130B Parametern bleiben, liegen die Kapazitäten chinesischer Labore zwischen 754B und 2,78 Billionen Parametern.
Interessant ist auch die Rolle der Hardware-Hersteller: Unternehmen wie NVIDIA und AMD veröffentlichen massiv neue Modelle, um ihre Chips zu bewerben. Ein optimiertes, frei verfügbares Modell ist der beste Beweis dafür, dass die Hardware funktioniert.
Ein wichtiges Unterscheidungsmerkmal ist die Diskrepanz zwischen Aufmerksamkeit und tatsächlicher Nutzung: “Likes” spiegeln die Begeisterung für neue Releases wider, während “Downloads” zeigen, was tatsächlich in den Pipelines der Entwickler fest verbaut ist. Während große Modelle oft viele Likes erhalten, sind es die kleinen, stabilen Modelle, die über Jahre hinweg die höchsten Download-Zahlen generieren.