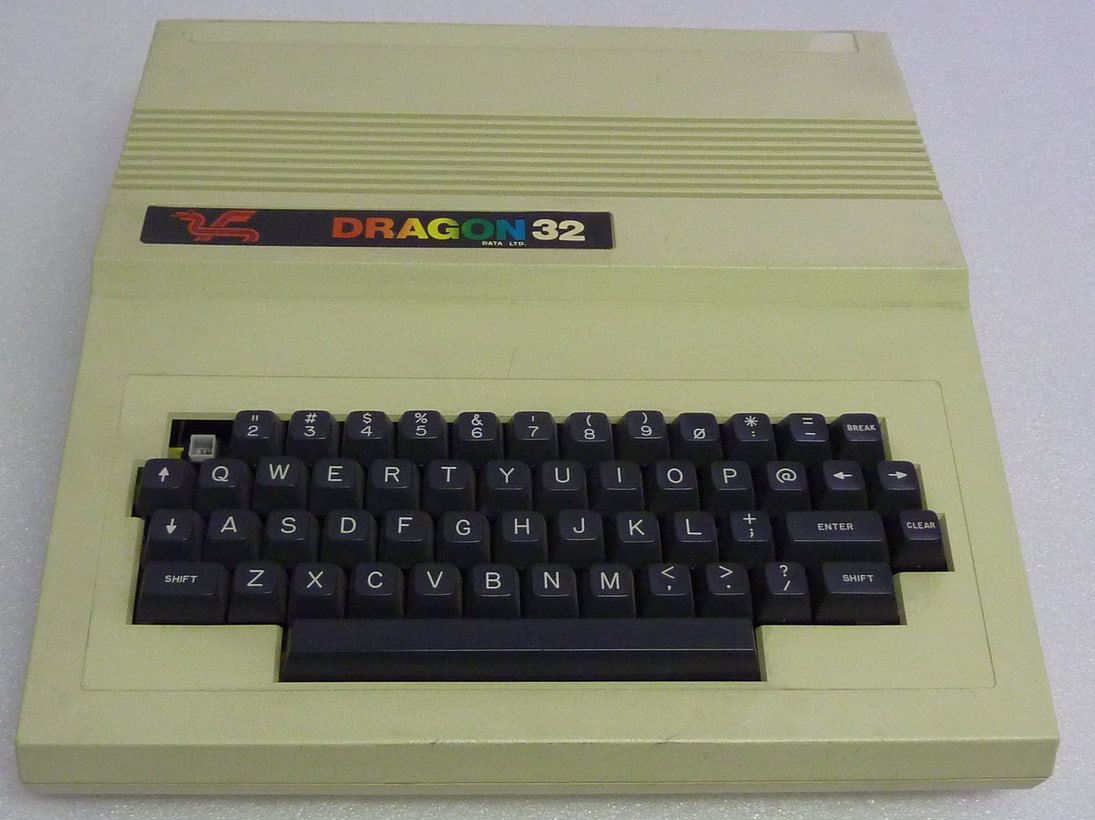
Коли мені було 13 років, я ще завантажував програми з касет і був щасливий, якщо вони поміщалися у 32 КБ. Порівняно з цим, доступність даних сьогодні величезна: на Hugging Face наразі доступно понад мільйон наборів даних для найрізноманітніших застосувань. “Сіль” у цьому супі ніколи ще не була такою дешевою.
Якість даних та бенчмарки
Хоча обсяг даних гігантський, виникає питання: чи є бенчмарк для цих даних? Мені пощастило знайти відповідні дані та розширити їх настільки, що я зміг на їхній основі навчити свою першу LoRA.
Під час цього стало зрозуміло: навчання ШІ-моделей потребує не лише часу та потужностей GPU, а насамперед якісних даних — таких, яких базова модель ще не знає.
Проєкт: від голосового повідомлення до медичного висновку
Я розробив проєкт, який перетворює аудіофайли (діалог 1:1) на транскрибований, а згодом і анонімізований медичний висновок у форматі PDF. За бажанням цей проєкт можна протестувати в навчальних цілях.
Конвеєр (pipeline) проєкту виглядає так: Голосове повідомлення з Telegram перетворюється на текст за допомогою WhisperX та Pyannote (включаючи діаризацію спікерів). Цей транскрибований текст потім перетворюється на структурований формат PTV-3 JSON за допомогою моделі Qwen2.5-7B, яка була донавчена (fine-tuned) за допомогою LoRA (4-bit QLoRA). Кінцевим результатом є звіт у форматі PDF розміром DIN A4, який надсилається через Telegram.
Проєкт було реалізовано у три етапи:
- Етап 1 (Telegram Bot + Транскрипція): Бот приймає голосові повідомлення, транскрибує їх за допомогою WhisperX (large-v3) та виконує розпізнавання спікерів за допомогою Pyannote, щоб повернути відформатований транскрипт.
- Етап 2 (Генерація синтетичних даних): Було створено 311 синтетичних німецьких прикладів (280 для навчання, 31 для валідації) для LoRA Fine-Tuning. Це було зроблено шляхом двоступеневого синтезу за допомогою локальної Qwen2.5-27B: спочатку генерувалися клінічні профілі (діагноз, демографія, цілі терапії), на основі яких створювалися симульовані транскрипти терапії та відповідні структуровані PTV-3 JSON звіти.
- Етап 3 (QLoRA Fine-Tuning + Оцінка): LoRA-адаптер розміром 155 МБ був навчений за допомогою Unsloth (4-bit QLoRA) на основі моделі Qwen2.5-7B-Instruct. Оцінка проводилася за допомогою ROUGE-L, структурних перевірок, косинусної схожості (Cosine Similarity) та Pydantic.
Навчання даних проводилося на RTX 5090 (32 ГБ VRAM) протягом 90 хвилин за 3 епохи, при цьому було досягнуто фінального значення Loss 0,37 та косинусної схожості 0,92.
Розвиток Open Models
Світ ШІ рухається надзвичайно швидко. Згідно зі звітом Hugging Face за літо 2026 року, публічні репозиторії моделей, набори даних та Spaces зростають щодня в величезних масштабах. Проте спостерігається екстремально нерівномірний розподіл: тоді як кількість наборів даних зросла до понад мільйона, на 99,2% усіх завантажень припадає лише 1,5% репозиторіїв.
Помітним трендом 2026 року є швидкість розробки. Якщо раніше лабораторії часто починали з невеликих моделей, поступово переходячи до складніших, то китайські лабораторії часто повністю пропускають цей процес. Найпотужніші Open-Source моделі з Китаю в багато місяців значно перевершують моделі зі США. У той час як моделі США часто залишаються в межах 130B параметрів, потужності китайських лабораторій варіюються від 754B до 2,78 трильйона параметрів.
Цікавою є також роль виробників обладнання: такі компанії, як NVIDIA та AMD, випускають величезну кількість нових моделей для реклами своїх чипів. Оптимізована, вільно доступна модель — найкращий доказ того, що залізо працює.
Важливою відмінністю є розрив між увагою та фактичним використанням: “лайки” відображають захоплення новими релізами, тоді як “завантаження” показують те, що насправді інтегровано в конвеєри розробників. Хоча великі моделі часто отримують багато лайків, саме маленькі, стабільні моделі протягом багатьох років генерують найвищі показники завантажень.